Casts
Team
Blog
News
Articles
More
Welcome
Investor Information
Terms
Contact ScienceCast
Sign Up
Sign Up
Log In
MedFailBench: A Clinician-Built Open-Source Be...
Artificial Intelligence
Goktug Ozkan
200 views
Can We Trust Item Response Theory for AI Evalu...
Artificial Intelligence
Han Jiang
176 views
Benchmarking Multimodal Large Language Models ...
Artificial Intelligence
Patrick Do
191 views
SearchOS-V1: Towards Robust Open-Domain Inform...
Artificial Intelligence
librarian
179 views
The Industrialization of Research ; On AI-Driv...
Artificial Intelligence
Emmanuel Jeannot
200 views
Pretraining Data Can Be Poisoned through Compu...
Artificial Intelligence
Victoria Graf
171 views
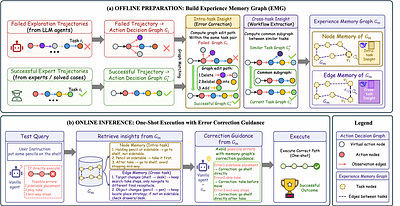
Experience Memory Graph: One-Shot Error Correc...
Artificial Intelligence
Wenjun Wang
187 views
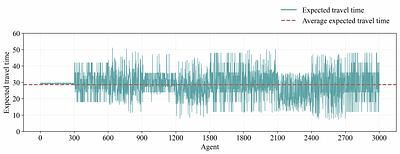
Reproducing human biases in route choice using...
Artificial Intelligence
Shuxian Xu
201 views
Interaction Scaling: Grounding the Third Axis ...
Artificial Intelligence
Bojie Li
195 views
Think Through a Bottleneck: Hourglass Reasonin...
Artificial Intelligence
librarian
146 views
Filtering Harmful Actions Isn't Enough: Phanto...
Artificial Intelligence
librarian
135 views
AUTOPILOT VQA: Benchmarking Vision-Language Mo...
Artificial Intelligence
librarian
133 views
Using AI-based Learning Assistants in Higher E...
Artificial Intelligence
librarian
146 views
The Illusion of Equivalency: Statistical Chara...
Artificial Intelligence
librarian
144 views
SolarChain-Eval: A Physics-Constrained Benchma...
Artificial Intelligence
Luyao Zhang
128 views
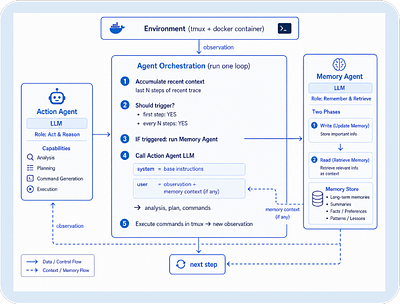
Remember When It Matters: Proactive Memory Age...
Artificial Intelligence
librarian
146 views
Ideas Have Genomes: Benchmarking Scientific Li...
Artificial Intelligence
librarian
192 views
Reason Less, Verify More: Deterministic Gates ...
Artificial Intelligence
librarian
124 views
Institutional Red-Teaming: Deployment Rules, N...
Artificial Intelligence
Yujiao Chen
117 views
RL Post-Training Builds Compositional Reasonin...
Artificial Intelligence
librarian
135 views
Search, Fail, Recover: A Training Framework fo...
Artificial Intelligence
librarian
107 views
Recursive Self-Improvement in AI: From Bounded...
Artificial Intelligence
librarian
162 views
SkillCenter: A Large-Scale Source-Grounded Ski...
Artificial Intelligence
librarian
105 views
DT-Guard: Intent-Driven Reasoning-Active Train...
Artificial Intelligence
librarian
114 views
Doomed from the Start: Early Abort of LLM Agen...
Artificial Intelligence
librarian
130 views
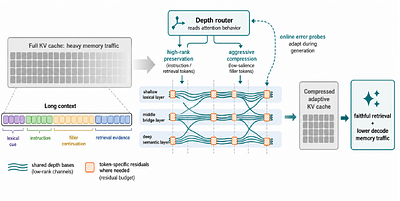
DepthWeave-KV: Token-Adaptive Cross-Layer Resi...
Artificial Intelligence
Anna Córdoba
137 views
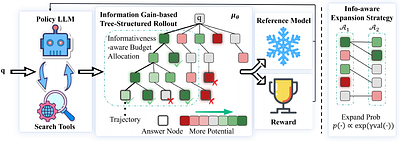
Information Gain-based Rollout Policy Optimiza...
Artificial Intelligence
Yijun Zhang
136 views
From Application-Layer Simulation to Native Me...
Artificial Intelligence
librarian
135 views
ExplAIner: A Declarative Query Language for Ex...
Artificial Intelligence
librarian
118 views
Danus: Orchestrating Mathematical Reasoning Ag...
Artificial Intelligence
librarian
197 views
AgentGym2: Benchmarking Large Language Model A...
Artificial Intelligence
librarian
128 views
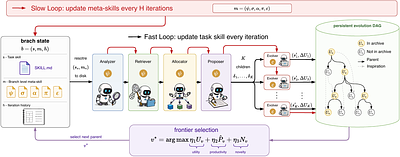
MetaSkill-Evolve: Recursive Self-Improvement o...
Artificial Intelligence
librarian
159 views